|
||||||
|

Fusion gene:CHMP4B_CBFA2T2 (FusionGDB2 ID:HG128866TG9139) |
Fusion Gene Summary for CHMP4B_CBFA2T2 |
 Fusion gene summary |
| Fusion gene information | Fusion gene name: CHMP4B_CBFA2T2 | Fusion gene ID: hg128866tg9139 | Hgene | Tgene | Gene symbol | CHMP4B | CBFA2T2 | Gene ID | 128866 | 9139 |
| Gene name | charged multivesicular body protein 4B | CBFA2/RUNX1 partner transcriptional co-repressor 2 | |
| Synonyms | C20orf178|CHMP4A|CTPP3|CTRCT31|SNF7|SNF7-2|Shax1|VPS32B|Vps32-2|dJ553F4.4 | EHT|MTGR1|ZMYND3|p85 | |
| Cytomap | 20q11.22 | 20q11.21-q11.22 | |
| Type of gene | protein-coding | protein-coding | |
| Description | charged multivesicular body protein 4bSNF7 homolog associated with Alix 1Snf7 homologue associated with Alix 1chromatin modifying protein 4Bchromatin-modifying protein 4bvacuolar protein-sorting-associated protein 32-2 | protein CBFA2T2CBFA2/RUNX1 translocation partner 2ETO homolog on chromosome 20ETO homologous on chromosome 20MTG8-like proteinMTG8-related protein 1core-binding factor, runt domain, alpha subunit 2; translocated to, 2myeloid translocation gene-rela | |
| Modification date | 20240407 | 20240305 | |
| UniProtAcc | . | . | |
| Ensembl transtripts involved in fusion gene | ENST00000217402, | ||
| Fusion gene scores | * DoF score | * DoF score (Degree of Frequency) = # partners X # break points X # disease types 11 X 4 X 9=396 | * DoF score (Degree of Frequency) = # partners X # break points X # disease types 7 X 25 X 18=3150 |
| # samples | 25 | 38 | |
| ** MAII score | ** MAII score (Major Active Isofusion Index) = log2(# samples/DoF score*10) log2(25/396*10)=-0.663572335417522 possibly effective Gene in Pan-Cancer Fusion Genes (peGinPCFGs). DoF>8 and MAII<0 | ** MAII score (Major Active Isofusion Index) = log2(# samples/DoF score*10) log2(38/3150*10)=-3.05128050494369 possibly effective Gene in Pan-Cancer Fusion Genes (peGinPCFGs). DoF>8 and MAII<0 | |
| Context | PubMed: CHMP4B [Title/Abstract] AND CBFA2T2 [Title/Abstract] AND fusion [Title/Abstract] | ||
| Most frequent breakpoint | CHMP4B(32399464)-CBFA2T2(32224445), # samples:1 | ||
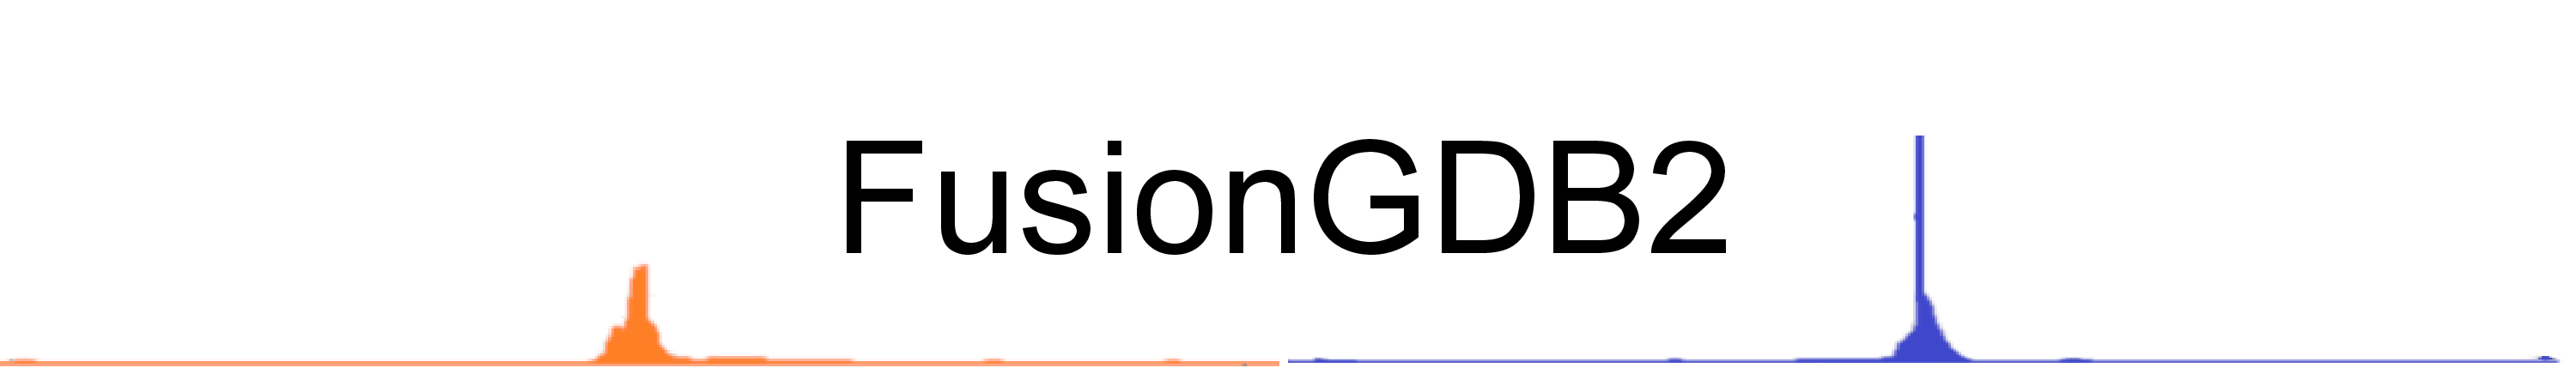
| Fusion gene breakpoints across CHMP4B (5'-gene) * Click on the image to open the UCSC genome browser with custom track showing this image in a new window. |
 |
| Fusion gene breakpoints across CBFA2T2 (3'-gene) * Click on the image to open the UCSC genome browser with custom track showing this image in a new window. |
 |
Top |
Fusion Gene Breakpoints for CHMP4B_CBFA2T2 |
| RNA-seq based exon junction arranged fusion gene breakpoints from 8 resources (TCGA, CCLE, cBioPortal, GenBank, ChimerDB, ChimerKB, ChildHoodFusions, and GTEx). For the expressed sample information, go to Fusion Gene Sample section. |
| Hgene | Hchr | Hbp | Tgene | Tchr | Tbp |
| CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32399464 |
| CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32232153 |
| CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32224446 |
| CHMP4B | chr20 | 33811658 | CBFA2T2 | chr20 | 33644347 |
| CHMP4B | chr20 | 33811658 | CBFA2T2 | chr20 | 33623115 |
| CHMP4B | chr20 | 33811658 | CBFA2T2 | chr20 | 33636640 |
| DNA-seq based exon junction arranged fusion gene breakpoints from dbVar. For the expressed sample information, go to Fusion Gene Sample section. |
| Hgene | Hchr | Hbp | Tgene | Tchr | Tbp | SV type |
Top |
Tumorigenic MoA (Mechanism of Action) Scenarios of Fusion Genes for CHMP4B_CBFA2T2 |
| To generate these tumorigenic scenario annotations, we implemented a deduction-first, retrieval-later computational framework. The pipeline first applies rule-guided reasoning across ten core mechanistic categories (M1–M10) derived from fusion gene biology to infer candidate mechanisms, tumorigenic scenarios, targeting points, and targeting backgrounds. To ensure empirical accountability, a governed Python workflow retrieves literature candidates via NCBI E-utilities and Europe PMC using tiered searches. Using JSON Schema-constrained LLM evidence judges (GPT-5.6 Luna and Terra), retrieved articles are evaluated for specificity and confidence without de novo PMID generation. This produces two distinct versions: a strict version restricted to high- or medium-confidence fusion-specific evidence, and an extended version incorporating broader gene-, pathway-, and contextual evidence. |
| Constitutively Active Kinases, Catalytic Domain Dysregulation, & Transmembrane Ligand Fusions | Aberrant Chimeric Transcription Factor / Fusion Transcription Factor Activity | Epigenetic Reprogramming / Histone Modifier Dysregulation | Chromatin Remodeling Dysregulation | Condensate-Driven Transcriptional Rewiring / LLP | Promoter / Enhancer Hijacking | Dominant-Negative Antagonism | Cell Cycle / Checkpoint Bypass / RNA Processing Dysregulation | Subcellular Mislocalization / Spatial Dysregulation | Nuclear Body / Sub-organellar Architecture Disruption & Differentiation Blockade |  |  |  |  |  |  |  |  |  |  |
* Strict version: Restricted to high- or medium-confidence fusion-specific evidence.
| Fusion Gene Name | Mechanism Category | Mechanism PubMed | Tumorigenic Scenarios | Tumorigenic Scenario PubMed | Targeting Points | Targeting PubMed | Mechanism Background | Mechanism Background PubMed |
* Extended version: Includes all strict-level fusion evidence plus broader gene-, pathway-, and low-confidence contextual evidence.
| Fusion Gene Name | Mechanism Category | Mechanism PubMed | Tumorigenic Scenarios | Tumorigenic Scenario PubMed | Targeting Points | Targeting PubMed | Mechanism Background | Mechanism Background PubMed |
| Main function of each fusion partner protein. (from UniProt) |
| Hgene | Tgene |
| . | . |
| Gene ontology of each fusion partner gene with evidence of Inferred from Direct Assay (IDA) from Entrez |
| Partner | Gene | GO ID | GO term | PubMed ID |
| Hgene | CHMP4B | GO:0001778 | plasma membrane repair | 24482116 |
| Hgene | CHMP4B | GO:0039702 | viral budding via host ESCRT complex | 24878737 |
| Hgene | CHMP4B | GO:0043162 | ubiquitin-dependent protein catabolic process via the multivesicular body sorting pathway | 17984323 |
| Hgene | CHMP4B | GO:0046761 | viral budding from plasma membrane | 24878737 |
| Hgene | CHMP4B | GO:0051258 | protein polymerization | 18209100 |
| Hgene | CHMP4B | GO:0071985 | multivesicular body sorting pathway | 16554368 |
| Tgene | CBFA2T2 | GO:0010976 | positive regulation of neuron projection development | 19026687 |
| Tgene | CBFA2T2 | GO:0045892 | negative regulation of DNA-templated transcription | 23251453 |
Top |
Fusion Genomic Features for CHMP4B_CBFA2T2 |
| FusionAI prediction of the potential fusion gene breakpoint based on the pre-mature RNA sequence context (+/- 5kb of individual partner genes, total 20kb length sequence) of In-frame fusion genes. FusionAI is a fusion gene breakpoint classifier based on convolutional neural network by comparing the fusion positive and negative sequence context of ~ 20K fusion gene data. From here, we can have the relative potentency of the 20K genomic sequence how individual sequnce will be likely used as the gene fusion breakpoints. |
| Hgene | Hchr | Hbp | Hstrand | Tgene | Tchr | Tbp | Tstrand | 1-p | p (fusion gene breakpoint) |
| CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32224445 | + | 1.25e-14 | 1.00e+00 |
| CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32232152 | + | 6.96e-13 | 1.00e+00 |
| FusionAI prediction of the potential fusion gene breakpoint based on the pre-mature RNA sequence context (+/- 5kb of individual partner genes, total 20kb length sequence) of 5UTR-3CSD fusion genes (N-truncated cases). |
| Hgene | Hchr | Hbp | Hstrand | Tgene | Tchr | Tbp | Tstrand | 1-p | p (fusion gene breakpoint) |
| FusionAI prediction of the potential fusion gene breakpoint based on the pre-mature RNA sequence context (+/- 5kb of individual partner genes, total 20kb length sequence) of 5CDS-3UTR fusion genes (C-truncated cases). |
| Hgene | Hchr | Hbp | Hstrand | Tgene | Tchr | Tbp | Tstrand | 1-p | p (fusion gene breakpoint) |
| Distribution of six genomic regulatory feature tracks across a ±5 kb window centered on the fusion breakpoints. We input the breakpoint sequences into AlphaGenome and obtained predicted genome tracks at single-base-pair resolution for each modality by running a single forward pass over the reference sequence. Specifically, for each breakpoint, AlphaGenome processed and returned predicted track data across diverse modalities, which were then averaged across all tracks within each output type and visualized across the ±5 kb window. The left panel shows the 5'-gene breakpoint ±5 kb area, and the right panel shows the 3'-gene breakpoint area, with tracks grouped by category: chromatin accessibility (DNase-seq, ATAC-seq), active transcription (RNA-seq, CAGE), and chromatin binding (ChIP-Histone, ChIP-TF). |
 |
Top |
Fusion Gene ORF Annotations for CHMP4B_CBFA2T2 |
| Open reading frame (ORF) analsis of fusion genes based on Ensembl gene isoform structure. * Click on the break point to see the gene structure around the break point region using the UCSC Genome Browser. |
| ORF | Henst | Tenst | Hgene | Hchr | Hbp | Hstrand | Tgene | Tchr | Tbp | Tstrand |
| 5CDS-3UTR | ENST00000217402 | ENST00000491618 | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32224445 | + |
| Frame-shift | ENST00000217402 | ENST00000342704 | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32232152 | + |
| In-frame | ENST00000217402 | ENST00000342704 | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32224445 | + |
| In-frame | ENST00000217402 | ENST00000375279 | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32224445 | + |
| In-frame | ENST00000217402 | ENST00000375279 | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32232152 | + |
| ORFfinder Result Based On The Fusion Transcript Sequences of the In-frame Fusion Genes. |
| Henst | Tenst | Hgene | Hchr | Hbp | Tgene | Tchr | Tbp | Seq length (transcript) | Seq length (peptide) |
| ENST00000217402 | ENST00000342704 | CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32224445 | 355 | 94 |
| ENST00000217402 | ENST00000375279 | CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32224445 | 355 | 249 |
| ENST00000217402 | ENST00000375279 | CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32232152 | 355 | 249 |
| ORFfinder Result Based On The Fusion Transcript Sequences of the 5UTR-3CDS Fusion Genes for N-Truncated Protein Search. |
| Henst | Tenst | Hgene | Hchr | Hbp | Tgene | Tchr | Tbp | Seq length (transcript) | Seq length (peptide) |
| ORFfinder Result Based On The Fusion Transcript Sequences of the 5CDS-3UTR Fusion Genes for C-Truncated Protein Search. |
| Henst | Tenst | Hgene | Hchr | Hbp | Tgene | Tchr | Tbp | Seq length (transcript) | Seq length (peptide) |
| DeepORF Prediction of The Coding Potential Based on The Fusion Transcript Sequence of In-frame Fusion Genes. DeepORF is a Coding Potential Classifier Based on Convolutional Neural Network by Comparing the Real Ribo-seq Data. If the No-coding Score < 0.5 and Coding Score > 0.5, Then The In-frame Fusion Transcript is Predicted as Being Likely Translated. |
| Henst | Tenst | Hgene | Hchr | Hbp | Tgene | Tchr | Tbp | No-coding score | Coding score |
| ENST00000217402 | ENST00000342704 | CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32224445 | 3.38e-03 | 9.97e-01 |
| ENST00000217402 | ENST00000375279 | CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32224445 | 1.90e-02 | 9.81e-01 |
| ENST00000217402 | ENST00000375279 | CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32232152 | 6.22e-01 | 3.78e-01 |
| DeepORF Prediction of The Coding Potential Based on The Fusion Transcript Sequence of 5UTR-3CDS Fusion Genes (Potential N-Truncated Proteins). |
| Henst | Tenst | Hgene | Hchr | Hbp | Tgene | Tchr | Tbp | No-coding score | Coding score |
| DeepORF Prediction of The Coding Potential Based on The Fusion Transcript Sequence of 5CDS-3UTR Fusion Genes (Potential C-Truncated Proteins). |
| Henst | Tenst | Hgene | Hchr | Hbp | Tgene | Tchr | Tbp | No-coding score | Coding score |
| ENST00000217402 | ENST00000491618 | CHMP4B | chr20 | 32399464 | CBFA2T2 | chr20 | 32224445 | 0.00e+00 | 9.50e-03 |
Top |
Fusion Protein Retained/Non-Retained Functional Features for CHMP4B_CBFA2T2 |
| Protein Level Annotation from FGviewer * Retention analysis result of each fusion partner protein across 39 protein features of UniProt such as six molecule processing features, 13 region features, four site features, six amino acid modification features, two natural variation features, five experimental info features, and 3 secondary structure features. Here, because of limited space for viewing, we only show the protein feature retention information belong to the 13 regional features. All retention annotation result can be downloaded at download page. Minus value of BPloci means that the break pointn is located before the CDS. |
 |
| - In-frame and retained protein feature among the 13 regional features (visualization across fusion protein length). |
CHMP4B_CBFA2T2_chr20-32399464_chr20-32224445.png |
CHMP4B_CBFA2T2_chr20-32399464_chr20-32232152.png |
| - In-frame and retained protein feature among the 13 regional features (texts). |
| Partner | Gene | Hbp | Tbp | ENST | Strand | BPexon | TotalExon | Protein feature loci | *BPloci | TotalLen | Protein feature | Protein feature note |
| Hgene | CHMP4B | chr20:32399464 | chr20:32224445 | ENST00000217402 | Q9H444 | 1 | 5 | 8_19 | 63.333333333333336 | 225.0 | Compositional bias | Gly residues |
| Hgene | CHMP4B | chr20:32399464 | chr20:32232152 | ENST00000217402 | Q9H444 | 1 | 5 | 8_19 | 63.333333333333336 | 225.0 | Compositional bias | Gly residues |
| Hgene | CHMP4B | chr20:32399464 | chr20:32224445 | ENST00000217402 | Q9H444 | 1 | 5 | 1_23 | 63.333333333333336 | 225.0 | Region | Disordered |
| Hgene | CHMP4B | chr20:32399464 | chr20:32232152 | ENST00000217402 | Q9H444 | 1 | 5 | 1_23 | 63.333333333333336 | 225.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 451_491 | 409.3333333333333 | 596.0 | Coiled coil | Ontology_term=ECO:0000255 |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 583_598 | 409.3333333333333 | 596.0 | Compositional bias | Low complexity |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 583_598 | 505.0 | 605.0 | Compositional bias | Low complexity |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 435_484 | 409.3333333333333 | 596.0 | Region | Nervy homology region 3 (NHR3) |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 547_604 | 409.3333333333333 | 596.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 547_604 | 505.0 | 605.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 507_543 | 409.3333333333333 | 596.0 | Zinc finger | MYND-type |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 507_543 | 505.0 | 605.0 | Zinc finger | MYND-type |
| - In-frame and not-retained protein feature among the 13 regional features. |
| Partner | Gene | Hbp | Tbp | ENST | Strand | BPexon | TotalExon | Protein feature loci | *BPloci | TotalLen | Protein feature | Protein feature note |
| Hgene | CHMP4B | chr20:32399464 | chr20:32224445 | ENST00000217402 | Q9H444 | 1 | 5 | 23_183 | 63.333333333333336 | 225.0 | Coiled coil | Ontology_term=ECO:0000255 |
| Hgene | CHMP4B | chr20:32399464 | chr20:32232152 | ENST00000217402 | Q9H444 | 1 | 5 | 23_183 | 63.333333333333336 | 225.0 | Coiled coil | Ontology_term=ECO:0000255 |
| Hgene | CHMP4B | chr20:32399464 | chr20:32224445 | ENST00000217402 | Q9H444 | 1 | 5 | 185_224 | 63.333333333333336 | 225.0 | Region | Disordered |
| Hgene | CHMP4B | chr20:32399464 | chr20:32232152 | ENST00000217402 | Q9H444 | 1 | 5 | 185_224 | 63.333333333333336 | 225.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 451_491 | 505.0 | 605.0 | Coiled coil | Ontology_term=ECO:0000255 |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 236_251 | 409.3333333333333 | 596.0 | Compositional bias | Basic and acidic residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 402_419 | 409.3333333333333 | 596.0 | Compositional bias | Polar residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 46_59 | 409.3333333333333 | 596.0 | Compositional bias | Pro residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 64_79 | 409.3333333333333 | 596.0 | Compositional bias | Polar residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 88_105 | 409.3333333333333 | 596.0 | Compositional bias | Polar residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 236_251 | 505.0 | 605.0 | Compositional bias | Basic and acidic residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 402_419 | 505.0 | 605.0 | Compositional bias | Polar residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 46_59 | 505.0 | 605.0 | Compositional bias | Pro residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 64_79 | 505.0 | 605.0 | Compositional bias | Polar residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 88_105 | 505.0 | 605.0 | Compositional bias | Polar residues |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 113_208 | 409.3333333333333 | 596.0 | Domain | TAFH |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 113_208 | 505.0 | 605.0 | Domain | TAFH |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 229_265 | 409.3333333333333 | 596.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 25_105 | 409.3333333333333 | 596.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 331_377 | 409.3333333333333 | 596.0 | Region | Nervy homology region 2 (NHR2) |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32224445 | ENST00000342704 | O43439 | 7 | 11 | 397_427 | 409.3333333333333 | 596.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 229_265 | 505.0 | 605.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 25_105 | 505.0 | 605.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 331_377 | 505.0 | 605.0 | Region | Nervy homology region 2 (NHR2) |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 397_427 | 505.0 | 605.0 | Region | Disordered |
| Tgene | CBFA2T2 | chr20:32399464 | chr20:32232152 | ENST00000375279 | O43439 | 10 | 12 | 435_484 | 505.0 | 605.0 | Region | Nervy homology region 3 (NHR3) |
| - Retained PPIs in in-frame fusion. |
| Partner | Hgene | Hbp | Tgene | Tbp | ENST | UniProt | Strand | BPexon | TotalExon | Protein feature loci | *BPloci | TotalLen | Still interaction with |
| - Lost PPIs in in-frame fusion. |
| Partner | Hgene | Hbp | Tgene | Tbp | ENST | UniProt | Strand | BPexon | TotalExon | Protein feature loci | *BPloci | TotalLen | Interaction lost with |
Top |
Fusion Transcript Sequence for CHMP4B_CBFA2T2 |
| In-frame Fusion Transcript Sequences. |
>CHMP4B_CBFA2T2_ENST00000217402_ENST00000342704_32399464_32224445 length=1810nt Breakpoint=355nt GGTGGCGCGGCCGGGCCCAGCTGCGGGGCGGAGGCGGAGGCGGAGGAGAGGCCTGCGGCGGCAGGGAGCGGCGGGACTGGGAGCGGGCGCCGGAGCCGACCCGAGCCGAGCCGAGCCGAGCCGAGCCGGAGCGGGCGGCGAAGGCCGGCG CGGCGAGCAGCAACCATGTCGGTGTTCGGGAAGCTGTTCGGGGCTGGAGGGGGTAAGGCCGGCAAGGGCGGCCCGACCCCCCAGGAGGCCATCCAGCGGCTGCGGGACACGGAAGAGATGTTAAGCAAGAAACAGGAGTTCCTGGAGAAG AAAATCGAGCAGGAGCTGACGGCCGCCAAGAAGCACGGCACCAAAAACAAGCGCGATTCTCAGAGAGAGTTCAACAGCAGGCCAGGTACAGGATACGTACCTGTGGAGTTTTGGAAAAAAACAGAAGAAGCTGTGAATAAGGTGAAAATT CAGGCCATGTCAGAAGTACAGAAGGCCGTCGCTGAGGCAGAGCAGAAAGCCTTTGAAGTGATTGCAACAGAGAGAGCACGAATGGAGCAAACCATAGCGGATGTCAAGCGGCAGGCCGCAGAGGATGCTTTCCTCGTCATCAATGAGCAA GAGGAGTCCACGGAGAACTGCTGGAACTGTGGCCGCAAAGCCAGCGAGACATGCAGTGGCTGCAATATCGCGCGATACTGTGGCTCTTTCTGCCAGCACAAGGACTGGGAGCGGCACCACCGCCTCTGTGGTCAGAACCTGCATGGCCAG AGCCCCCACGGCCAGGGCCGGCCGCTGCTTCCTGTAGGCAGGGGCTCCTCTGCCAGGTCCGCCGACTGCAGCGTGCCCAGCCCAGCCCTCGACAAGACCTCGGCAACCACATCGCGTTCCTCAACACCTGCTTCTGTGACAGCTATCGAC ACCAACGGACTCTGAGCCCCGGACTCTGCTTACCCTGATGGCTGCTCAGCACCACAGAGTGCTTGGGCTGAGGGACTGACTGTTGGAACCCGTGCATGTAGCTGCCGGGTCATCAGCAAGAAATGAATTGGAGGCAGGAAGAGTCCAAGC CTGAATAATAACACCCCACAGCCTCTCTGTGCACTTGCTGTCTGCGGAGCCAGTGTGCCATTCTCTGCACATGGGCAGCCAGCCTGAGCTGCCTCCTCCATGGCTTTCCTGGTTTGTTCCTCTCTCCACTGAAGCTGACTTAGCCGGCCC CTTTTCAGTGTAGACCACCAGCTCCCCTCCCCATCTCCTTGAGTCAGCAGACTGTCCAATGTGCTCAGCCAGGCTGGAGGCGGCAGGCGGCAGGCAGCAGGCTGTGGAGGAGGCCCCTCGGTCAGGGAGCGGCCTGCCTCACCCCTGAAT AGCTCCTTCGGCCCCATCTCCATCCTCAGCAGATGACACTGATTGGCCTCACGGGGACTTGGGTAAGCAACAGGCGGCATTCAGGACTCTTCTCAACCCTGCTGTTCAGACTTGATAAGATCTCAGAGTCCACAGGAAAGAAGTCACTGT TGCAATAAAAGCACCCGTAGTAGCAAAAACATAAAACAAATAAAACTTCCCCCACATCACAGATGATTTTGGACAAGATTTTCCAACCTTGCTGGCTACTTTAGTTTGGGACCTGTTTTTTTTCTCATTTGATTTTGCTTGTGCAGAAAA TAGTTTCCAGCACATGGATTGATCTGAGAGAGAATGAGGCTCAGTTGTGGATAGTCTGTTTTCTCTGAGCATGTTGGCCAACTAGTATCGTCAAATTATTGAGTGGATCATCTCTTGGAAATGCAGAACTTCTGCCACCACTTGGCTATT TGCACAGTCA >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445 length=6305nt Breakpoint=355nt GGTGGCGCGGCCGGGCCCAGCTGCGGGGCGGAGGCGGAGGCGGAGGAGAGGCCTGCGGCGGCAGGGAGCGGCGGGACTGGGAGCGGGCGCCGGAGCCGACCCGAGCCGAGCCGAGCCGAGCCGAGCCGGAGCGGGCGGCGAAGGCCGGCG CGGCGAGCAGCAACCATGTCGGTGTTCGGGAAGCTGTTCGGGGCTGGAGGGGGTAAGGCCGGCAAGGGCGGCCCGACCCCCCAGGAGGCCATCCAGCGGCTGCGGGACACGGAAGAGATGTTAAGCAAGAAACAGGAGTTCCTGGAGAAG AAAATCGAGCAGGAGCTGACGGCCGCCAAGAAGCACGGCACCAAAAACAAGCGCGATTCTCAGAGAGAGTTCAACAGCAGGCCAGGTACAGGATACGTACCTGTGGAGTTTTGGAAAAAAACAGAAGAAGCTGTGAATAAGGTGAAAATT CAGGCCATGTCAGAAGTACAGAAGGCCGTCGCTGAGGCAGAGCAGAAAGCCTTTGAAGTGATTGCAACAGAGAGAGCACGAATGGAGCAAACCATAGCGGATGTCAAGCGGCAGGCCGCAGAGGATGCTTTCCTCGTCATCAATGAGCAA GAGGAGTCCACGGAGAACTGCTGGAACTGTGGCCGCAAAGCCAGCGAGACATGCAGTGGCTGCAATATCGCGCGATACTGTGGCTCTTTCTGCCAGCACAAGGACTGGGAGCGGCACCACCGCCTCTGTGGTCAGAACCTGCATGGCCAG AGCCCCCACGGCCAGGGCCGGCCGCTGCTTCCTGTAGGCAGGGGCTCCTCTGCCAGGTCCGCCGACTGCAGCGTGCCCAGCCCAGCCCTCGACAAGACCTCGGCAACCACATCGCGTTCCTCAACACCTGCTTCTGTGACAGCTATCGAC ACCAACGGACTCTGAGCCCCGGACTCTGCTTACCCTGATGGCTGCTCAGCACCACAGAGTGCTTGGGCTGAGGGACTGACTGTTGGAACCCGTGCATGTAGCTGCCGGGTCATCAGCAAGAAATGAATTGGAGGCAGGAAGAGTCCAAGC CTGAATAATAACACCCCACAGCCTCTCTGTGCACTTGCTGTCTGCGGAGCCAGTGTGCCATTCTCTGCACATGGGCAGCCAGCCTGAGCTGCCTCCTCCATGGCTTTCCTGGTTTGTTCCTCTCTCCACTGAAGCTGACTTAGCCGGCCC CTTTTCAGTGTAGACCACCAGCTCCCCTCCCCATCTCCTTGAGTCAGCAGACTGTCCAATGTGCTCAGCCAGGCTGGAGGCGGCAGGCGGCAGGCAGCAGGCTGTGGAGGAGGCCCCTCGGTCAGGGAGCGGCCTGCCTCACCCCTGAAT AGCTCCTTCGGCCCCATCTCCATCCTCAGCAGATGACACTGATTGGCCTCACGGGGACTTGGGTAAGCAACAGGCGGCATTCAGGACTCTTCTCAACCCTGCTGTTCAGACTTGATAAGATCTCAGAGTCCACAGGAAAGAAGTCACTGT TGCAATAAAAGCACCCGTAGTAGCAAAAACATAAAACAAATAAAACTTCCCCCACATCACAGATGATTTTGGACAAGATTTTCCAACCTTGCTGGCTACTTTAGTTTGGGACCTGTTTTTTTTCTCATTTGATTTTGCTTGTGCAGAAAA TAGTTTCCAGCACATGGATTGATCTGAGAGAGAATGAGGCTCAGTTGTGGATAGTCTGTTTTCTCTGAGCATGTTGGCCAACTAGTATCGTCAAATTATTGAGTGGATCATCTCTTGGAAATGCAGAACTTCTGCCACCACTTGGCTATT TGCACAGTCATCTTGTTCTGTGTCCTTTTATCTCTCAGACCACACACATCTGGAACGCTGTGGGCATCTTCTGCCCATGGGCTCCATTTGGCACCTGCTGAGCCACAGTTGTCCTGCTGGATGTGCTGTGCAGGTTGGTAGGACTTGCCC CCACTGTCAAGGCCTGGTCTCATCTGAAAAGCCCTCCTGGACCTCAAAGAATTCTTCAGACCTCATAGTTACAGGTCATTATATCTACTATGTTGATTTATCATCAGGCACACAACTTCTGTTTCCTTCTCTTGTGTTATCTGATAGCGT CCCTCCTTGAGCTCATCAGAAAGGTTTTATGAAATGTGAACCATTTTGGGAAAAGCTGATCAATTTTTCTTCCTAGCTTCCCATTTTCAAATGGGACATCACTCATATCCCTTTCAGAATGTTAGGAACTGCCTCCCACATTCTTCCCTG TCTTTTTGGGTTTTGTTTTTTGTTGTTGTGGTGGTTTTTTAACACAAAGTCTCACTCTGTTGCCCAGGCTGGAGTGCAGTGGCATGATCTTGGCTCACTGCAACCTCTGCCTTCCAGGTTCAAGCAATTCTCCTGCCTCAGCCTCCCGAG TAGCTGAGATTACAGGCGCCCACCACCACGCCCAGCTAATTTTTGTATTTTTAGTAGAGACAGGGTTTCACCATGTTGGCCAGGCTGATCTCGAACTCCTGACCTCAGGTGACCTGCCTTGGCCTCCCAAAGTGCAGGGATTACAAGCGT GAGCCACCATGCCCGGCCTGTCTTTTTGGTTTTGATGGGAGTCTGAGGACCCCGACCCCTCCTGCTCTCCATCTTTGAGCCTCTGGCATCCTCTCACACCCAGAAATCAGTTGGAGTAAGTTTAATTGGCCCTGCTCCAGCTGGCCTTTG AAGCACAAGTTTAAATCTCCACCTTCTGTGCACTGACCAGAGTCTAAAATAAAAGTTGTCAGTACCATAAAGGAAAAGGGATCCACACAGGTAGCCTTCTCCTTGGATACAGGTACATCTTACTGTAAGAATTTCAAGTCCTGGCTGGGC GCAGTGGCTCACTCCTGTAATCCCAGCACTTTGAGAGACCGAGGCAGGCAGATCACTTGAGGTCAGGAATTCAAGACCAACCTGGCCAACATGGTGAAACCCTGTCTCTAATAAAAAAAAAATAGAAAAATCAGCCGGGTGTGGTGGCAC ACACCTGTAATCCTAGCTACTCAGGAGGCTGAGGCAAGAGAATCTCTTGAACCTGTGAGCCAGAGGTTGCAGTGAGCCGAGATTCCACCACTGCACTCCAGCCTGGGCAACAGAGCAAAACTCTGTCTCAAAAAAAAAAAAAAAAAGGCA AAATTAAAGAATTTCAAGTCCCTAATTTACTCTAACCAAGCATTTTCAGTCTTACAAAGAAATCTAGTGCACGACACCTTTAAAATGCCTAGATTTCCATTGCCTAAAGTAAGGTGTGACCAGTGAAACAACAGCAGAGAATCATGTTCC TTTGCTGTGGAACACATAAGCCCCACAGTTTTCCAGTCAGCCTAATACATGGGTATCCCCCGACCCCATCTGCCTCCTTAAGCCACAGTCCTTGGTGGGGAACTCTAAGGGGGACGGAGTCAGTACCCCGGACAGGGCCACATTTGCATG AGACATGGCTGTCTCACAGGTCACAGAGCCATTACAACAGCTTACTAGTTTTTCATGGATTTGTTGGATTAACACCTTAAGCAGGTTTTTTATTGTTATTTTGTTTGTTTGTTTGTTTTGAGACGGGAGTTTCTCTCTTGTCTCCCAGGC TGGAGTGCAATCGCGCAATCTCGGCTCACGGTAACCTCTGCCTCCCAGGTTCAAGCGAGTCTCCTGCCTCAGCCTTCTGAGTAGCTGGGATTACAGGCATGCGCCACCACGCCCAACTAATTTTGTATTTTTAGTAGAGACGGGGTTTCT CCTTGTTGGTCAGGCTGGTCTCAAACCCCGGACCTCAGGTGATCCCCCCACCTTGGCCTCCCAAAGTGCCAGGATTACAGGCATGAGCCACTGTGTCCGGTCTTGAGCAGGTTTTTAAAATCTCCAGTGGCCATAAAACTAGCCAGGGTA GCTCATGCTTTTACTGGTTGGAATAAGGAGCCAAAACCAACAAAATAATATTTATTAGGGCTCGATGCCCATTTCTGTGGCTAAGGCTTAGGTTTGGTGTGCAGAGCCTGGCCTGCTCTTGTGGGCTGTGGTTGCTGTGACAGTTTCGTT TTCTGAATCTTTGTAATGCTCTTCCACCCTGCTCGTGCTGCCCAGAGGCTGATCTGCAAACCTGGGCAGTATTCCACACTGAAGCTCAGTTTGCAAACCTTCTGCTGTGTTAATTCTGGTCAGTTTCACACAGAAGTCACGAGGGCCTCT GCCCAGGACCTTCTATTCACATTTCAAGAATCCCTTTCTGAAATTCTCCAACTCTCTGGTCAGGAGGAGGAGCACCATTGGGGCGGGGTAGGCAGCTAGAGGCGCAGGAGCGAATCCAGGTTCCTTGCGTGGTTCCCAGCCTCTGCTGAC AGCACCTCAGCTACCAGGTGGGGAGTGGAAATTCAGCCTGCTTAGAGGACTGACCTCTACAGTTCATATTTGCAGTGACATAAAAGGCAAAGAGGAGCTGGCATGGTGGTACAGAAGGTATCAGTCAAGCGCAGGCTCTTCAGAAACCTA GAAACTAAAAAGAGATGCAACATGTGACTGGCCATCAGCCAGACATGTCTAGGGTGAGACCAGTGCTCAGCACCACCCGCCAAGGAACACTGATGAGTTGTGGGACATTATGGTCGGCCAAGTGAGGAATGATTGCAGGGACCAGAGAAG ACCAAAGATGCCAGATGTCCCCAGAGTTTCTTGAGGGCTGGGTTTCACGTCTTTGCTTGTCCTTTTTGTCCCCACTTGCCTGCACCGTGCCTGACTCATCCAGTGGGGAAGGTGACTCAAGAAGTTGTTTAAGCCTAGGCCTAGGCAGTC CACTTCGGGAGGTGGGGGCACTCCACACTGGGGGGCCCTGCAGCTCCAGGGCTGGTGCTCTAGCAGATCCGCTCAGGCACGGTTGGGTGACCGTGGGGTCACCGATTGCGTAGATTATTTCTAGGGCAGTGCTGGGTTAGAAATGTCTGT CTGGAAACAGGACACATCTTGCCACCACAAGTCCACACCTGGCCTTGGCTGCTGCCCGCTCTCTGCAGCGTGGATTTCCTTTGCCCATTTGGGCCAGAAGGTCACCAGGAGTTCATCACTGCTTAGTGTCAACTTGACATCTTCAGCTTC CAGACAGAAAACCCATGCTTTACTTTGTACAGCCCTGTCCCAGAGTTAGTAAGCCTCGGCTTGTCACCTGCTTGCAAAGGGTATAGACATCATTCTGGGTAGTTCTAGAGGATATCGCAACAAGTGCGTTTGAAGGTTCAGCACAGCTGG AATTGTACGGTAGTGAGCTCTTCAAAATGAAAACAGAATGACCGGATGGCCATCTGTCCTGGAAACTGTAGAATTGAATAAATCACTGAAAATAGAACACTTCTTGGAGGCTTTCTTCAGAACTGAACTAGAAACAAGGTTTCCAGGCTC CCAGGTCAGTAGACCAAACCAACTTCCTTAGATTTTTTTTTTTAAGCTGTTTGCAGAAAACTGGGTGGTAGCGTGTCTGAACCAAACGGAAGAATAGCCAGCGGAGCATGGACTGTTCCAGCACGGGCCAGATGGCCAGCTGTCGAGAGC AGCCCTGCCCAGATTGCGGTGGGGGCTGTGCCAGCGGCTCCGCAGGGCCCTTCCAACTCTGGAGTGTCTGTAGTTCTTGTGAAACCAAAACGTTGACTACCTGCCTCTTTCCTCGGGCATCGACGTGCTCATTTCCAAAGATGATGGTGC AGGTGACCTTTTCCATCGTGAGCTAAGAGAAGGTTAGGAGGCCTGAGGGGCGGGCCTTGTGTCCCCTCCTCCCCCTCCACAGCCCCTGAGGTGGAGCTTCCCTCACAGACCCCATCTGGTCGAGCCTACGGCTGCCCAGTGTACACTCAG TGATGCTTATACCAAATAGGGCATGTGCGCTGGTGTCTGTTGGGGACAGCCCCATCCCTACCTTGGAGTCGGCAGAGAAGCAGCAATAAGCATTAGGCGAATGATTGAAAGGGCTGCTGCGCCAAGAGGCCTTCAGTCCCCTTAACGTGG CTTTCCAACTTCCTGACGAGGCTACAAAGGCTCCGCTCACAAAAGAAAGCCAATAATGTAAATAAATAGAAAACGAAGCCTCCACGCGTGGTTTTTAAAGGGGGATGATGAATGTGACACCACCCACAGAATGCATTAGAATCTGGTTTT TCTGTGCTTTGTCATTTTACTCTGATAGGAATTTTTGTTACCTAACTCTGTGCATAACTTATTTAATGTACTGTATAAATGAACCAAAACTGTTAAATATGTATTTAGTTTGTTCTACTTAAAGTAGTCAATAAAAAGGCTATATTCCTT TTCTG >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152 length=6045nt Breakpoint=355nt GGTGGCGCGGCCGGGCCCAGCTGCGGGGCGGAGGCGGAGGCGGAGGAGAGGCCTGCGGCGGCAGGGAGCGGCGGGACTGGGAGCGGGCGCCGGAGCCGACCCGAGCCGAGCCGAGCCGAGCCGAGCCGGAGCGGGCGGCGAAGGCCGGCG CGGCGAGCAGCAACCATGTCGGTGTTCGGGAAGCTGTTCGGGGCTGGAGGGGGTAAGGCCGGCAAGGGCGGCCCGACCCCCCAGGAGGCCATCCAGCGGCTGCGGGACACGGAAGAGATGTTAAGCAAGAAACAGGAGTTCCTGGAGAAG AAAATCGAGCAGGAGCTGACGGCCGCCAAGAAGCACGGCACCAAAAACAAGCGCGAACTGCTGGAACTGTGGCCGCAAAGCCAGCGAGACATGCAGTGGCTGCAATATCGCGCGATACTGTGGCTCTTTCTGCCAGCACAAGGACTGGGA GCGGCACCACCGCCTCTGTGGTCAGAACCTGCATGGCCAGAGCCCCCACGGCCAGGGCCGGCCGCTGCTTCCTGTAGGCAGGGGCTCCTCTGCCAGGTCCGCCGACTGCAGCGTGCCCAGCCCAGCCCTCGACAAGACCTCGGCAACCAC ATCGCGTTCCTCAACACCTGCTTCTGTGACAGCTATCGACACCAACGGACTCTGAGCCCCGGACTCTGCTTACCCTGATGGCTGCTCAGCACCACAGAGTGCTTGGGCTGAGGGACTGACTGTTGGAACCCGTGCATGTAGCTGCCGGGT CATCAGCAAGAAATGAATTGGAGGCAGGAAGAGTCCAAGCCTGAATAATAACACCCCACAGCCTCTCTGTGCACTTGCTGTCTGCGGAGCCAGTGTGCCATTCTCTGCACATGGGCAGCCAGCCTGAGCTGCCTCCTCCATGGCTTTCCT GGTTTGTTCCTCTCTCCACTGAAGCTGACTTAGCCGGCCCCTTTTCAGTGTAGACCACCAGCTCCCCTCCCCATCTCCTTGAGTCAGCAGACTGTCCAATGTGCTCAGCCAGGCTGGAGGCGGCAGGCGGCAGGCAGCAGGCTGTGGAGG AGGCCCCTCGGTCAGGGAGCGGCCTGCCTCACCCCTGAATAGCTCCTTCGGCCCCATCTCCATCCTCAGCAGATGACACTGATTGGCCTCACGGGGACTTGGGTAAGCAACAGGCGGCATTCAGGACTCTTCTCAACCCTGCTGTTCAGA CTTGATAAGATCTCAGAGTCCACAGGAAAGAAGTCACTGTTGCAATAAAAGCACCCGTAGTAGCAAAAACATAAAACAAATAAAACTTCCCCCACATCACAGATGATTTTGGACAAGATTTTCCAACCTTGCTGGCTACTTTAGTTTGGG ACCTGTTTTTTTTCTCATTTGATTTTGCTTGTGCAGAAAATAGTTTCCAGCACATGGATTGATCTGAGAGAGAATGAGGCTCAGTTGTGGATAGTCTGTTTTCTCTGAGCATGTTGGCCAACTAGTATCGTCAAATTATTGAGTGGATCA TCTCTTGGAAATGCAGAACTTCTGCCACCACTTGGCTATTTGCACAGTCATCTTGTTCTGTGTCCTTTTATCTCTCAGACCACACACATCTGGAACGCTGTGGGCATCTTCTGCCCATGGGCTCCATTTGGCACCTGCTGAGCCACAGTT GTCCTGCTGGATGTGCTGTGCAGGTTGGTAGGACTTGCCCCCACTGTCAAGGCCTGGTCTCATCTGAAAAGCCCTCCTGGACCTCAAAGAATTCTTCAGACCTCATAGTTACAGGTCATTATATCTACTATGTTGATTTATCATCAGGCA CACAACTTCTGTTTCCTTCTCTTGTGTTATCTGATAGCGTCCCTCCTTGAGCTCATCAGAAAGGTTTTATGAAATGTGAACCATTTTGGGAAAAGCTGATCAATTTTTCTTCCTAGCTTCCCATTTTCAAATGGGACATCACTCATATCC CTTTCAGAATGTTAGGAACTGCCTCCCACATTCTTCCCTGTCTTTTTGGGTTTTGTTTTTTGTTGTTGTGGTGGTTTTTTAACACAAAGTCTCACTCTGTTGCCCAGGCTGGAGTGCAGTGGCATGATCTTGGCTCACTGCAACCTCTGC CTTCCAGGTTCAAGCAATTCTCCTGCCTCAGCCTCCCGAGTAGCTGAGATTACAGGCGCCCACCACCACGCCCAGCTAATTTTTGTATTTTTAGTAGAGACAGGGTTTCACCATGTTGGCCAGGCTGATCTCGAACTCCTGACCTCAGGT GACCTGCCTTGGCCTCCCAAAGTGCAGGGATTACAAGCGTGAGCCACCATGCCCGGCCTGTCTTTTTGGTTTTGATGGGAGTCTGAGGACCCCGACCCCTCCTGCTCTCCATCTTTGAGCCTCTGGCATCCTCTCACACCCAGAAATCAG TTGGAGTAAGTTTAATTGGCCCTGCTCCAGCTGGCCTTTGAAGCACAAGTTTAAATCTCCACCTTCTGTGCACTGACCAGAGTCTAAAATAAAAGTTGTCAGTACCATAAAGGAAAAGGGATCCACACAGGTAGCCTTCTCCTTGGATAC AGGTACATCTTACTGTAAGAATTTCAAGTCCTGGCTGGGCGCAGTGGCTCACTCCTGTAATCCCAGCACTTTGAGAGACCGAGGCAGGCAGATCACTTGAGGTCAGGAATTCAAGACCAACCTGGCCAACATGGTGAAACCCTGTCTCTA ATAAAAAAAAAATAGAAAAATCAGCCGGGTGTGGTGGCACACACCTGTAATCCTAGCTACTCAGGAGGCTGAGGCAAGAGAATCTCTTGAACCTGTGAGCCAGAGGTTGCAGTGAGCCGAGATTCCACCACTGCACTCCAGCCTGGGCAA CAGAGCAAAACTCTGTCTCAAAAAAAAAAAAAAAAAGGCAAAATTAAAGAATTTCAAGTCCCTAATTTACTCTAACCAAGCATTTTCAGTCTTACAAAGAAATCTAGTGCACGACACCTTTAAAATGCCTAGATTTCCATTGCCTAAAGT AAGGTGTGACCAGTGAAACAACAGCAGAGAATCATGTTCCTTTGCTGTGGAACACATAAGCCCCACAGTTTTCCAGTCAGCCTAATACATGGGTATCCCCCGACCCCATCTGCCTCCTTAAGCCACAGTCCTTGGTGGGGAACTCTAAGG GGGACGGAGTCAGTACCCCGGACAGGGCCACATTTGCATGAGACATGGCTGTCTCACAGGTCACAGAGCCATTACAACAGCTTACTAGTTTTTCATGGATTTGTTGGATTAACACCTTAAGCAGGTTTTTTATTGTTATTTTGTTTGTTT GTTTGTTTTGAGACGGGAGTTTCTCTCTTGTCTCCCAGGCTGGAGTGCAATCGCGCAATCTCGGCTCACGGTAACCTCTGCCTCCCAGGTTCAAGCGAGTCTCCTGCCTCAGCCTTCTGAGTAGCTGGGATTACAGGCATGCGCCACCAC GCCCAACTAATTTTGTATTTTTAGTAGAGACGGGGTTTCTCCTTGTTGGTCAGGCTGGTCTCAAACCCCGGACCTCAGGTGATCCCCCCACCTTGGCCTCCCAAAGTGCCAGGATTACAGGCATGAGCCACTGTGTCCGGTCTTGAGCAG GTTTTTAAAATCTCCAGTGGCCATAAAACTAGCCAGGGTAGCTCATGCTTTTACTGGTTGGAATAAGGAGCCAAAACCAACAAAATAATATTTATTAGGGCTCGATGCCCATTTCTGTGGCTAAGGCTTAGGTTTGGTGTGCAGAGCCTG GCCTGCTCTTGTGGGCTGTGGTTGCTGTGACAGTTTCGTTTTCTGAATCTTTGTAATGCTCTTCCACCCTGCTCGTGCTGCCCAGAGGCTGATCTGCAAACCTGGGCAGTATTCCACACTGAAGCTCAGTTTGCAAACCTTCTGCTGTGT TAATTCTGGTCAGTTTCACACAGAAGTCACGAGGGCCTCTGCCCAGGACCTTCTATTCACATTTCAAGAATCCCTTTCTGAAATTCTCCAACTCTCTGGTCAGGAGGAGGAGCACCATTGGGGCGGGGTAGGCAGCTAGAGGCGCAGGAG CGAATCCAGGTTCCTTGCGTGGTTCCCAGCCTCTGCTGACAGCACCTCAGCTACCAGGTGGGGAGTGGAAATTCAGCCTGCTTAGAGGACTGACCTCTACAGTTCATATTTGCAGTGACATAAAAGGCAAAGAGGAGCTGGCATGGTGGT ACAGAAGGTATCAGTCAAGCGCAGGCTCTTCAGAAACCTAGAAACTAAAAAGAGATGCAACATGTGACTGGCCATCAGCCAGACATGTCTAGGGTGAGACCAGTGCTCAGCACCACCCGCCAAGGAACACTGATGAGTTGTGGGACATTA TGGTCGGCCAAGTGAGGAATGATTGCAGGGACCAGAGAAGACCAAAGATGCCAGATGTCCCCAGAGTTTCTTGAGGGCTGGGTTTCACGTCTTTGCTTGTCCTTTTTGTCCCCACTTGCCTGCACCGTGCCTGACTCATCCAGTGGGGAA GGTGACTCAAGAAGTTGTTTAAGCCTAGGCCTAGGCAGTCCACTTCGGGAGGTGGGGGCACTCCACACTGGGGGGCCCTGCAGCTCCAGGGCTGGTGCTCTAGCAGATCCGCTCAGGCACGGTTGGGTGACCGTGGGGTCACCGATTGCG TAGATTATTTCTAGGGCAGTGCTGGGTTAGAAATGTCTGTCTGGAAACAGGACACATCTTGCCACCACAAGTCCACACCTGGCCTTGGCTGCTGCCCGCTCTCTGCAGCGTGGATTTCCTTTGCCCATTTGGGCCAGAAGGTCACCAGGA GTTCATCACTGCTTAGTGTCAACTTGACATCTTCAGCTTCCAGACAGAAAACCCATGCTTTACTTTGTACAGCCCTGTCCCAGAGTTAGTAAGCCTCGGCTTGTCACCTGCTTGCAAAGGGTATAGACATCATTCTGGGTAGTTCTAGAG GATATCGCAACAAGTGCGTTTGAAGGTTCAGCACAGCTGGAATTGTACGGTAGTGAGCTCTTCAAAATGAAAACAGAATGACCGGATGGCCATCTGTCCTGGAAACTGTAGAATTGAATAAATCACTGAAAATAGAACACTTCTTGGAGG CTTTCTTCAGAACTGAACTAGAAACAAGGTTTCCAGGCTCCCAGGTCAGTAGACCAAACCAACTTCCTTAGATTTTTTTTTTTAAGCTGTTTGCAGAAAACTGGGTGGTAGCGTGTCTGAACCAAACGGAAGAATAGCCAGCGGAGCATG GACTGTTCCAGCACGGGCCAGATGGCCAGCTGTCGAGAGCAGCCCTGCCCAGATTGCGGTGGGGGCTGTGCCAGCGGCTCCGCAGGGCCCTTCCAACTCTGGAGTGTCTGTAGTTCTTGTGAAACCAAAACGTTGACTACCTGCCTCTTT CCTCGGGCATCGACGTGCTCATTTCCAAAGATGATGGTGCAGGTGACCTTTTCCATCGTGAGCTAAGAGAAGGTTAGGAGGCCTGAGGGGCGGGCCTTGTGTCCCCTCCTCCCCCTCCACAGCCCCTGAGGTGGAGCTTCCCTCACAGAC CCCATCTGGTCGAGCCTACGGCTGCCCAGTGTACACTCAGTGATGCTTATACCAAATAGGGCATGTGCGCTGGTGTCTGTTGGGGACAGCCCCATCCCTACCTTGGAGTCGGCAGAGAAGCAGCAATAAGCATTAGGCGAATGATTGAAA GGGCTGCTGCGCCAAGAGGCCTTCAGTCCCCTTAACGTGGCTTTCCAACTTCCTGACGAGGCTACAAAGGCTCCGCTCACAAAAGAAAGCCAATAATGTAAATAAATAGAAAACGAAGCCTCCACGCGTGGTTTTTAAAGGGGGATGATG AATGTGACACCACCCACAGAATGCATTAGAATCTGGTTTTTCTGTGCTTTGTCATTTTACTCTGATAGGAATTTTTGTTACCTAACTCTGTGCATAACTTATTTAATGTACTGTATAAATGAACCAAAACTGTTAAATATGTATTTAGTT TGTTCTACTTAAAGTAGTCAATAAAAAGGCTATATTCCTTTTCTG |
| N-Truncated Transcript (5UTR-3CDS) Sequences |
| C-Truncated Transcript (5CDS-3UTR) Sequences |
>CHMP4B_CBFA2T2_ENST00000217402_ENST00000491618_32399464_32224445 length=355nt Breakpoint=355nt GGTGGCGCGGCCGGGCCCAGCTGCGGGGCGGAGGCGGAGGCGGAGGAGAGGCCTGCGGCGGCAGGGAGCGGCGGGACTGGGAGCGGGCGCCGGAGCCGACCCGAGCCGAGCCGAGCCGAGCCGAGCCGGAGCGGGCGGCGAAGGCCGGCG CGGCGAGCAGCAACCATGTCGGTGTTCGGGAAGCTGTTCGGGGCTGGAGGGGGTAAGGCCGGCAAGGGCGGCCCGACCCCCCAGGAGGCCATCCAGCGGCTGCGGGACACGGAAGAGATGTTAAGCAAGAAACAGGAGTTCCTGGAGAAG AAAATCGAGCAGGAGCTGACGGCCGCCAAGAAGCACGGCACCAAAAACAAGCGCG |
Top |
Fusion Protein Sequence for CHMP4B_CBFA2T2 |
| In-frame Fusion Protein Sequences. |
>CHMP4B_CBFA2T2_ENST00000217402_ENST00000342704_32399464_32224445 length=94nt MERPRRSRPKNWDRVPYRRDCGASACRTSPPSGETAPLLPRAPHHRGLGGPAANTASLRCPGVLLRALAAQAPPRILRSRFRKKSTSSSATETT >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445 length=249nt MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152 length=249nt MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL |
| N-Truncated Protein (5UTR-3CDS) Sequences |
| C-Truncated Protein (5CDS-3UTR) Sequences |
Top |
Personalized Fusion Protein Sequence for CHMP4B_CBFA2T2 |
| TCGA Kinase/DNA-binding Domain Mutated Fusion Protein Sequences |
| Num | Gene Group | Domain Loci | Fusion Protein ID | Fusion Gene Name | Partner | Mutated Residue in WT Protein | Seq. Length | Mutated Residue in Fusion Protein |
| CCLE Kinase/DNA-binding Domain Mutated Fusion Protein Sequences |
| Num | Gene Group | Domain Loci | Fusion Protein ID | Fusion Gene Name | Partner | Mutated Residue in WT Protein | Seq. Length | Mutated Residue in Fusion Protein |
| TCGA All Mutated Fusion Protein Sequences |
>CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.A461T_249_A106T length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVTEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.R487Q;p.A524T_249_R132Q;A169T length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKQQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNITRYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.A483V_249_A128V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIVDVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.G563S_249_G208S length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVSRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.A524V_249_A169V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIVRYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.T592A_249_T237A length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSAPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.V575M_249_V220M length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSMPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.A452V_249_A97V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQVMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.K447N_249_K92N length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNNVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.E462K_249_E107K length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAKAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.V575M_249_V220M length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSMPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.S420Y_249_S65Y length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDYQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_5-gene_p.S2L_249_S2L length=249AA MLVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.E462K_249_E107K length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAKAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.G528S_249_G173S length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCSSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_5-gene_p.P20Q_249_P20Q length=249AA MSVFGKLFGAGGGKAGKGGQTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.G565D_249_G210D length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRDSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.R538W_249_R183W length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWEWHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.D484N_249_D129N length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIANVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.F530L_249_F175L length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSLCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_5-gene_p.G5W_249_G5W length=249AA MSVFWKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.F424L_249_F69L length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQRELNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_5-gene_p.E34D_249_E34D length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEDMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.A594V_249_A239V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPVSVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.P561R_249_P206R length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLRVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.D419N_249_D64N length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRNSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.N522I_249_N167I length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCIIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_3-gene_p.F437I_249_F82I length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEIWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32224445_5-gene_p.F42I_249_F42I length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEILEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.A461T_249_A106T length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVTEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.R487Q;p.A524T_249_R132Q;A169T length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKQQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNITRYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.A483V_249_A128V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIVDVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.G563S_249_G208S length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVSRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.A524V_249_A169V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIVRYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.T592A_249_T237A length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSAPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.V575M_249_V220M length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSMPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.A452V_249_A97V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQVMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.K447N_249_K92N length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNNVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.E462K_249_E107K length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAKAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.V575M_249_V220M length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSMPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.S420Y_249_S65Y length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDYQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_5-gene_p.S2L_249_S2L length=249AA MLVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.E462K_249_E107K length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAKAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.G528S_249_G173S length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCSSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_5-gene_p.P20Q_249_P20Q length=249AA MSVFGKLFGAGGGKAGKGGQTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.G565D_249_G210D length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRDSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.R538W_249_R183W length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWEWHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.D484N_249_D129N length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIANVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.F530L_249_F175L length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSLCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_5-gene_p.G5W_249_G5W length=249AA MSVFWKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.F424L_249_F69L length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQRELNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_5-gene_p.E34D_249_E34D length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEDMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.A594V_249_A239V length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPVSVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.P561R_249_P206R length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLRVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.D419N_249_D64N length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRNSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.N522I_249_N167I length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCIIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_3-gene_p.F437I_249_F82I length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEFLEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEIWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL >CHMP4B_CBFA2T2_ENST00000217402_ENST00000375279_32399464_32232152_5-gene_p.F42I_249_F42I length=249AA MSVFGKLFGAGGGKAGKGGPTPQEAIQRLRDTEEMLSKKQEILEKKIEQELTAAKKHGTKNKRDSQREFNSRPGTGYVPVEFWKKTEEAVNKVKIQAMSEVQKAVAEAEQKAFEVIATERARMEQTIADVKRQAAEDAFLVINEQEESTE NCWNCGRKASETCSGCNIARYCGSFCQHKDWERHHRLCGQNLHGQSPHGQGRPLLPVGRGSSARSADCSVPSPALDKTSATTSRSSTPASVTAIDTNGL |
| Fusion Protein ID | Sample ID | Mutated Partner | AAchange in WT | Seq. Length | AAchange in Fusion |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-20-1686-01A | 3-gene | p.A461T | 249 | A106T |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-2W-A8YY-01A | 3-gene | p.R487Q;p.A524T | 249 | R132Q;A169T |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-A5-A0G2-01A | 3-gene | p.A483V | 249 | A128V |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-A6-6648-01A | 3-gene | p.G563S | 249 | G208S |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-AA-3864-01A | 3-gene | p.A524V | 249 | A169V |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-AN-A046-01A | 3-gene | p.T592A | 249 | T237A |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-AU-6004-01A | 3-gene | p.V575M | 249 | V220M |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-AZ-4315-01A | 3-gene | p.A452V | 249 | A97V |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-BF-A1Q0-01A | 3-gene | p.K447N | 249 | K92N |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-BH-A2L8-01A | 3-gene | p.E462K | 249 | E107K |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-BR-7703-01A | 3-gene | p.V575M | 249 | V220M |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-BS-A0UV-01A | 3-gene | p.S420Y | 249 | S65Y |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-C5-A902-01A | 5-gene | p.S2L | 249 | S2L |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-C8-A274-01A | 3-gene | p.E462K | 249 | E107K |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-CJ-4923-01A | 3-gene | p.G528S | 249 | G173S |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-D3-A3CE-06A | 5-gene | p.P20Q | 249 | P20Q |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-D3-A8GN-06A | 3-gene | p.G565D | 249 | G210D |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-DU-6392-01A | 3-gene | p.R538W | 249 | R183W |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-DU-6407-02B | 3-gene | p.D484N | 249 | D129N |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-E7-A5KE-01A | 3-gene | p.F530L | 249 | F175L |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-EB-A299-01A | 5-gene | p.G5W | 249 | G5W |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-EE-A181-06A | 3-gene | p.F424L | 249 | F69L |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-EO-A3B0-01A | 5-gene | p.E34D | 249 | E34D |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-FW-A3R5-06A | 3-gene | p.A594V | 249 | A239V |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-IB-7651-01A | 3-gene | p.P561R | 249 | P206R |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-JW-A5VL-01A | 3-gene | p.D419N | 249 | D64N |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-OE-A75W-01A | 3-gene | p.N522I | 249 | N167I |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-RD-A8N6-01A | 3-gene | p.F437I | 249 | F82I |
| ENST00000217402_ENST00000375279_32399464_32224445 | TCGA-WP-A9GB-01A | 5-gene | p.F42I | 249 | F42I |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-20-1686-01A | 3-gene | p.A461T | 249 | A106T |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-2W-A8YY-01A | 3-gene | p.R487Q;p.A524T | 249 | R132Q;A169T |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-A5-A0G2-01A | 3-gene | p.A483V | 249 | A128V |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-A6-6648-01A | 3-gene | p.G563S | 249 | G208S |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-AA-3864-01A | 3-gene | p.A524V | 249 | A169V |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-AN-A046-01A | 3-gene | p.T592A | 249 | T237A |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-AU-6004-01A | 3-gene | p.V575M | 249 | V220M |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-AZ-4315-01A | 3-gene | p.A452V | 249 | A97V |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-BF-A1Q0-01A | 3-gene | p.K447N | 249 | K92N |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-BH-A2L8-01A | 3-gene | p.E462K | 249 | E107K |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-BR-7703-01A | 3-gene | p.V575M | 249 | V220M |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-BS-A0UV-01A | 3-gene | p.S420Y | 249 | S65Y |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-C5-A902-01A | 5-gene | p.S2L | 249 | S2L |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-C8-A274-01A | 3-gene | p.E462K | 249 | E107K |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-CJ-4923-01A | 3-gene | p.G528S | 249 | G173S |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-D3-A3CE-06A | 5-gene | p.P20Q | 249 | P20Q |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-D3-A8GN-06A | 3-gene | p.G565D | 249 | G210D |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-DU-6392-01A | 3-gene | p.R538W | 249 | R183W |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-DU-6407-02B | 3-gene | p.D484N | 249 | D129N |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-E7-A5KE-01A | 3-gene | p.F530L | 249 | F175L |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-EB-A299-01A | 5-gene | p.G5W | 249 | G5W |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-EE-A181-06A | 3-gene | p.F424L | 249 | F69L |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-EO-A3B0-01A | 5-gene | p.E34D | 249 | E34D |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-FW-A3R5-06A | 3-gene | p.A594V | 249 | A239V |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-IB-7651-01A | 3-gene | p.P561R | 249 | P206R |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-JW-A5VL-01A | 3-gene | p.D419N | 249 | D64N |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-OE-A75W-01A | 3-gene | p.N522I | 249 | N167I |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-RD-A8N6-01A | 3-gene | p.F437I | 249 | F82I |
| ENST00000217402_ENST00000375279_32399464_32232152 | TCGA-WP-A9GB-01A | 5-gene | p.F42I | 249 | F42I |
| CCLE All Mutated Fusion Protein Sequences |
| Fusion Protein ID | Sample ID | Mutated Partner | AAchange in WT | Seq. Length | AAchange in Fusion |
Top |
Fusion Gene Exprssed Samples for CHMP4B_CBFA2T2 |
| RNA-seq based fusion gene expressed samples. |
| Source | Study | Disease | Sample | Hgene | Hchr | Hbp | Hstrand | Tgene | Tchr | Tbp | Tstrand |
| ChimerDB | BRCA | TCGA-AR-A256-01A | CHMP4B | chr20 | 32399464 | - | CBFA2T2 | chr20 | 0 | + | |
| ChimerDB | BRCA | TCGA-AR-A256-01A | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32399464 | + | |
| ChimerDB | BRCA | TCGA-AR-A256 | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32399464 | + | |
| ChimerDB | BRCA | TCGA-B6-A0I1-01A | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32399464 | + | |
| ChimerDB | LIHC | TCGA-FV-A496-01A | CHMP4B | chr20 | 32399464 | - | CBFA2T2 | chr20 | 0 | + | |
| ChimerDB | LIHC | TCGA-FV-A496-01A | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32399464 | + | |
| ChimerDB | STAD | TCGA-CG-4449-01A | CHMP4B | chr20 | 32399464 | - | CBFA2T2 | chr20 | 0 | + | |
| ChimerDB | STAD | TCGA-CG-4449-01A | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32399464 | + | |
| ChimerDB | STAD | TCGA-CG-4449 | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32399464 | + | |
| TCGAfusionPortal | BRCA | TCGA-AR-A256-01A | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32232153 | + | |
| WashU | BRCA | TCGA-AR-A256-01A | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32232153 | + | |
| WashU | LIHC | TCGA-FV-A496-01A | CHMP4B | chr20 | 32399464 | + | CBFA2T2 | chr20 | 32224446 | + | |
| cBioPortal | BRCA_TCGA_PAN_CAN_ATLAS_2018 | BRCA | TCGA-AR-A256-01 | CHMP4B | chr20 | 33811658 | CBFA2T2 | chr20 | 33644347 | ||
| cBioPortal | BRCA_TCGA_PAN_CAN_ATLAS_2018 | BRCA | TCGA-B6-A0I1-01 | CHMP4B | chr20 | 33811658 | CBFA2T2 | chr20 | 33623115 | ||
| cBioPortal | LIHC_TCGA_PAN_CAN_ATLAS_2018 | HCC | TCGA-FV-A496-01 | CHMP4B | chr20 | 33811658 | CBFA2T2 | chr20 | 33636640 |
| DNA-seq based fusion gene expressed samples. |
| Source | Study | Disease | Sample | Hgene | Hchr | Hbp | Hstrand | Tgene | Tchr | Tbp | Tstrand | SV type |
Top |
Related Drugs for CHMP4B_CBFA2T2 |
| PubMed Abstract Search With ['A-B' AND 'drug'], ['A::B' AND 'drug'] * For more details on the Studied, Reported, Approved Drugs targeting this fusion gene, Go to FusionPub. |
| PMID | Fusion Gene Name | Drug | Study Title |
| Drugs targeting genes involved in this fusion gene. (DrugBank Version 5.1.8 2021-05-08) |
| Partner | Gene | UniProtAcc | DrugBank ID | Drug name | Drug activity | Drug type | Drug status |
 Copyright 2021-Present -The University of Texas Health Science Center at Houston
(UTHealth)
Web File Viewing | Emergency Information |Campus Carry|Site Policies